Der Alltag ist voller Probleme, bei denen die Informationen nicht konstant sind, sondern sich im Laufe der Zeit ändern. Zum Beispiel kommunizieren wir durch Schallwellen, die von Moment zu Moment variieren; oder sogar während der Filmnacht, wo die aufregenden Erzählungen durch eine Reihe von Bildern erzählt werden. Im Bereich der künstlichen Intelligenz ist die Verarbeitung dieser Art von Informationen von größter Bedeutung, bei herkömmlichen Architekturen für neuronale Netzwerke ist ihre Verwendbarkeit jedoch begrenzt. In diesem Beitrag werden verschiedene Probleme und Lösungen beschrieben, die die Architekturen von Seq2Seq und den Attention Mechanism detailliert beschreiben.
Voraussetzungen (9-12 Minuten): Vertrautheit mit der RNN-Struktur und der LSTM-Schicht
In Fällen, in denen E / A-Informationen Daten serieller Art sind (geschriebener Text, Sprache, Video, Übersetzung), sollten Recurrent (RNN) neuronale Netzwerke verwendet werden, anstelle der herkömmlichen Fully Connected (FC) neuronalen Netzwerke, da die gesamte Reihe von Informationen ist nicht immer in vollem Umfang verfügbar (behindert die Verarbeitung) und herkömmliche FCs können aufgrund ihrer Eigenschaften nicht gut generalisiert werden. Das Wort “blau” wird in den meisten Fällen als Farbattribut verwendet. Dies muss jedoch für ein FC-Netz für jede Position geändert werden, wodurch die Effizienz des Modells verringert und die für dieselbe Genauigkeit erforderliche Rechenkapazität erhöht wird.
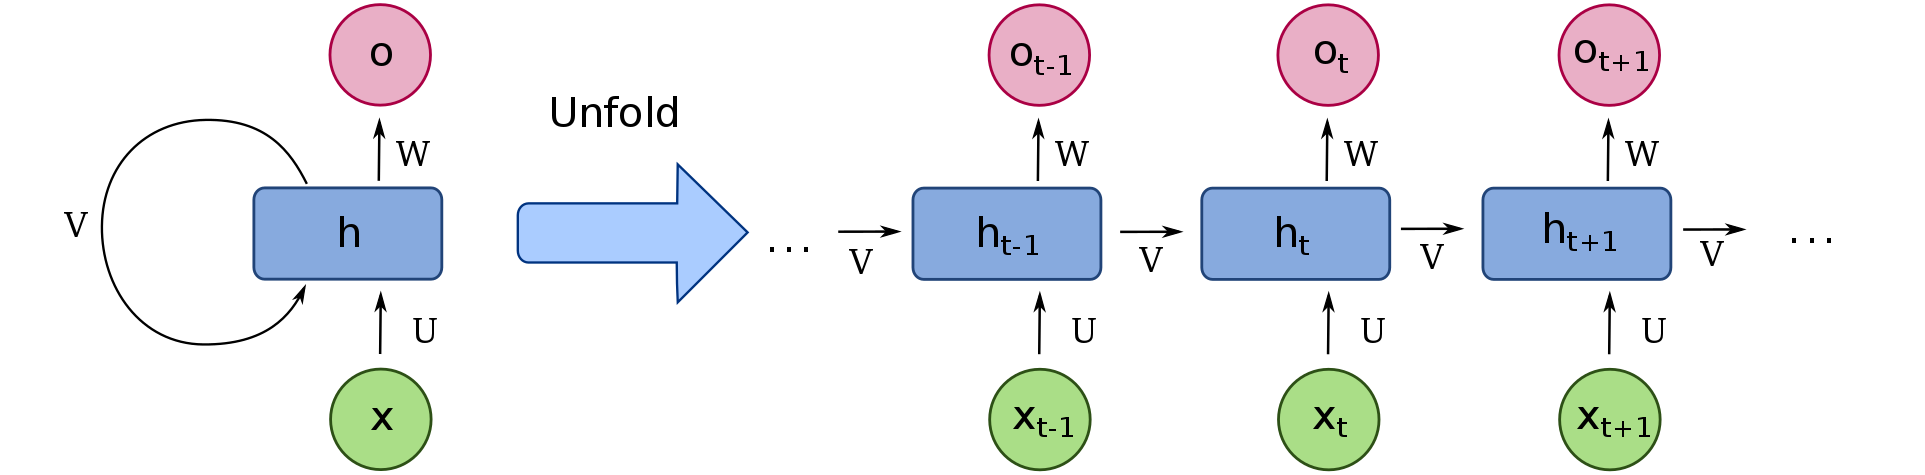
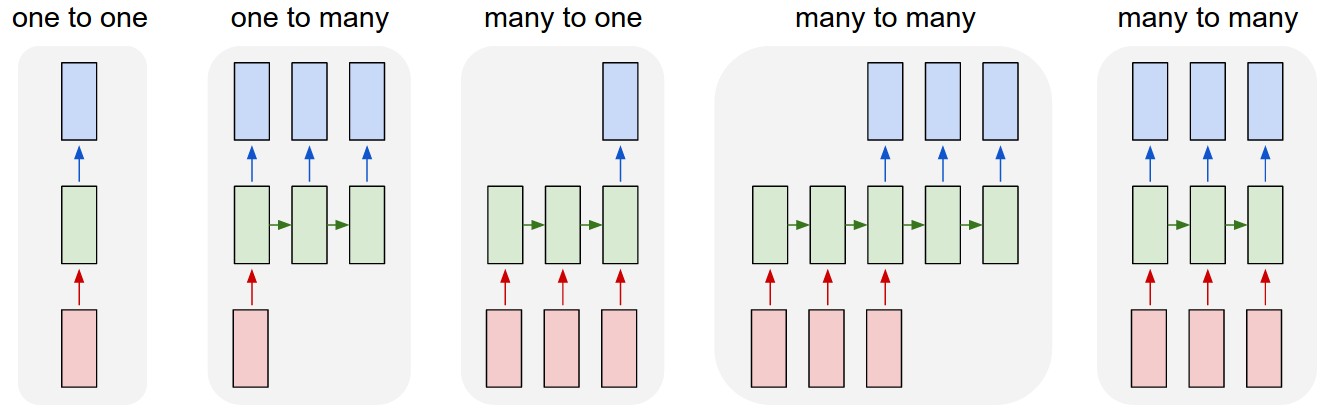
Traditionelle RNN-Strukturen sind nützlich für many-to-one/one-to-many-Probleme (z. B. Textklassifizierung nach Stimmung) oder für many-to-many Probleme, bei denen die Eingabe- und Ausgabereihenfolge die gleiche Länge haben. In der Abbildung steht das Blau für die Ausgänge und das Rot für die Eingänge.
SEQ2SEQ
Im Falle von Many-to-Many-Problemen (Eingangs- und Ausgangslänge sind unterschiedlich) müssen SEQ2SEQ-Strukturen verwendet werden: Ein Encodernet komprimiert die Eingangssequenz in einen Vektor, den wir an ein Decodernet übergeben, wodurch die gewünschte Ausgangssequenz erstellt wird. Eine typische Anwendung ist die Übersetzung: Der Encoder ist für die Interpretation des englischen Satzes und der Decoder für die Bildung des deutschen Satzes verantwortlich. SEQ2SEQ-Architekturen verwenden den im letzten Zeitschritt vom Encoder erzeugten verborgenen Zustandsvektor, um Informationen zu übermitteln. Dies wird als Kontextvektor bezeichnet.
Es gibt grundsätzlich zwei Möglichkeiten, den Kontextvektor des Codierers an den Decodierer zu übergeben. Diese werden im Folgenden kurz beschrieben:
- Der Kontextvektor wird bei jedem Schritt statisch dem Eingang des Decodernetzes zugeführt. In diesem Fall werden die anfänglichen internen Zustandsvariablen des Decodernetzes zufällig initialisiert. Diese Methode ist weniger verbreitet.
- Der Kontextvektor wird in einen anfänglichen internen Zustand des Decodierernetzes (init) gebracht, und im Fall einer Vorhersage werden die Eingaben dem geschätzten Ausgang des Decodierers beim vorherigen Zeitschritt zugeführt (außer für den vorherigen Zeitschritt, für den ein besonderer Wert vorliegt) Startzeichen wird verwendet). Diese Art von Netz wird gelehrt, indem die modifizierte Zielsequenz (um einen Zeitschritt verschoben) dem Eingang des Decodernetzes zugeführt wird (beginnend mit dem Startobjekt). Dies wird als teacherforcing bezeichnet. Ein Problem beim teacherforcing kann das Auftreten von verrauschten Ausgaben an der Eingabe zur Testzeit sein, für die eine Lösung für eine scheduled sampling vorgesehen ist, die die Eingabe des Decodernetzes während des Trainings zufällig zwischen den realen Daten (Lehrerzwingen) und den vorhergesagten Daten schaltet von selbst im vorherigen Zeitschritt.
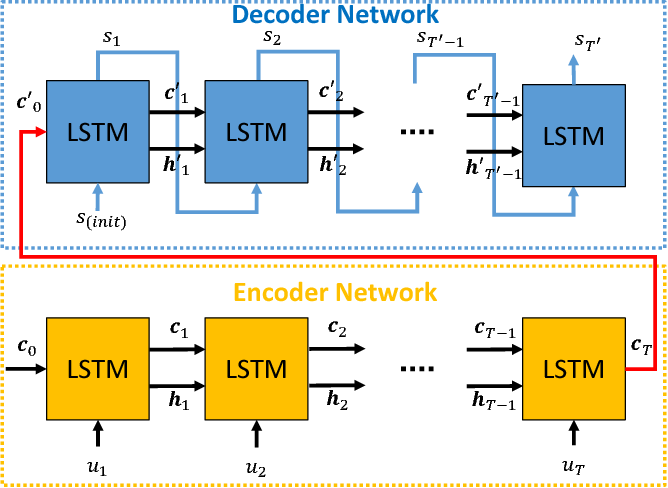
Bei der Verarbeitung langer Sätze mit SEQ2SEQ-Architekturen stößt man auf zwei Hindernisse. Man leitet sich von der RNN-Schicht ab, die SEQ2SEQ-Strukturen darstellt: die verschwindenden / explodierenden Gradienten und das daraus resultierende Verschwinden von Informationen. Dies kann gelöst werden, indem die SEQ2SEQ-Struktur aus LSTM-Schichten anstelle von RNN erstellt wird (siehe Abbildung [3]). Langes Kurzzeitgedächtnis hilft, wichtige Informationen vom Satzanfang bis zum Kontextvektor am Ende zu liefern. Das zweite Problem wird durch die SEQ2SEQ-Architektur verursacht, d. H. Den Kontextvektor mit fester Länge (dessen Dimension gleich der Einheitsnummer der LSTM-Layer ist). Der Encoder verfügt über einen einzigen Vektor, der die Bedeutung des gesamten Satzes einbettet und weitergibt. Dies ist für lange Sätze schwer zu erreichen, und man kann sehen, dass traditionelle menschliche Übersetzung auch nicht so funktioniert. Diese Einschränkung wird durch die Tatsache verursacht, dass es aufgrund der Schnittstelle mit fester Länge bei sehr ähnlichen Wörtern schwierig ist, Feinheiten zu codieren, die die Grundlagen der Qualitätsübersetzung sind. Der Attention Mechanism wurde entwickelt, um dieses Problem zu lösen.
ATTENTION
Die zwei populären Attention Mechanism sind die Attention von Bahdanau [4] und die Attention von Loung [5]. Ihre Innovation ist, dass die Modelle die Encoder / Decoder-Schnittstelle nicht auf den Kontextvektor des Encoders beschränken. Sie ermöglichen die Berücksichtigung des Encoder-Ausgangswertes zu jedem Zeitschritt beim Übersetzen, nicht nur den letzten. Dies wird durch einen sogenannten Attention-Kontextvektor erreicht (der nicht mit dem herkömmlichen SEQ2SEQ-Kontextvektor zu verwechseln ist, da dies nur der letzte Encoderstatus ist). Dieser Vektor wird aus den Kodierungen der Eingabeinformationen (Wörter, Buchstaben, Bilder, Töne) berechnet. Die Entscheidungsfindung und das Verstehen von Menschen erfolgen auf ähnliche Weise. Beim Lesen untersuchen wir einen Teil eines Satzes und konzentrieren uns während des visuellen Prozesses nur auf ein einzelnes Objekt. Dieser Vektor kann auf verschiedene Arten erstellt werden.
Bei der Kontextvektorberechnung von Attention wird die Eingabedatenkodierung berücksichtigt: Je nach Umfang (Gesamtheit oder nur bestimmte Teile) gibt es globale oder lokale Attention. Je nachdem, wie der Attentionsvektor aus diesen ausgewählten Kodierungen konstruiert wird, können wir über weiche oder harte Aufmerksamkeit sprechen.
SOFT ATTENTION:
Soft Attention wird durch die Gewichtung und Summierung der Kodierungen für die verschiedenen Zeitschritte berechnet. Die Gewichtung kann auf verschiedene Arten erfolgen (z. B. mithilfe eines herkömmlichen neuronalen FC-Netzwerks mit Softmax-Aktivierung basierend auf dem vorherigen verborgenen Zustand und den angegebenen Eingabecodierungen). Daher ist die Summe der Gewichtungen gleich 1, so dass eine Wahrscheinlichkeitsverteilung für jede Eingabecodierung berechnet wird. Die Kodierungen werden dann mit den Gewichtungen multipliziert und diese gewichteten Kodierungen werden aufsummiert. Dies wird als Aufmerksamkeitsvektor bezeichnet.
HARD ATTENTION:
In Hard Attention wird die Wahrscheinlichkeitsverteilung nicht zur Bildung einer gewichteten Summe verwendet, sondern als Faktor, der die Abtastfrequenz steuert. In diesem Fall wird der Aufmerksamkeitskontextvektor von den abgetasteten Kodierungen gemäß der Monte-Carlo-Methode abgeleitet. Diese Methode kann nicht in allen Fällen unterschieden werden (sie kann mit Reinforcement Learning berechnet werden), daher ist der Soft-Attention-Ansatz weiter verbreitet.
Der Kontextvektor kann dann auf verschiedene Weise zu einem LSTM-Netzwerk hinzugefügt werden. Nachfolgend einige Beispiele. Die Notationen wurden als Referenz standardisiert.
VEREINFACHT ATTENTION, NUR DER INTEGRIERTE VEKTOR
GLOBAL, SOFT, FC GEWICHTET ATTENTION
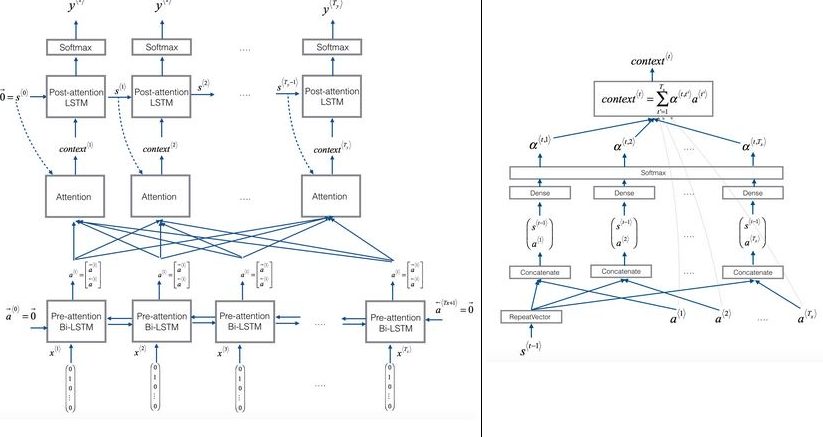
Ausschließlich der Aufmerksamkeitskontextvektor wird dem Eingang des Decoders zugeführt. Dieses Modell ähnelt der Struktur von I. SEQ2SEQ, mit dem Unterschied, dass der Kontextvektor hier nicht statisch ist, sondern bei jedem Zeitschritt mit Hilfe von Attention neu berechnet wird. Wir erstellen die Gewichtung mit Hilfe eines neuronalen FC-Netzwerks basierend auf dem vorherigen verborgenen Zustand des Decoders und den Codierungen.
VEREINFACHTE AUFMERKSAMKEIT, KOMBINIERT MIT EINEM SPRACHMODELL
GLOBAL, SOFT, ARBITRARIL GEWICHTET AUFMERKSAMKEIT
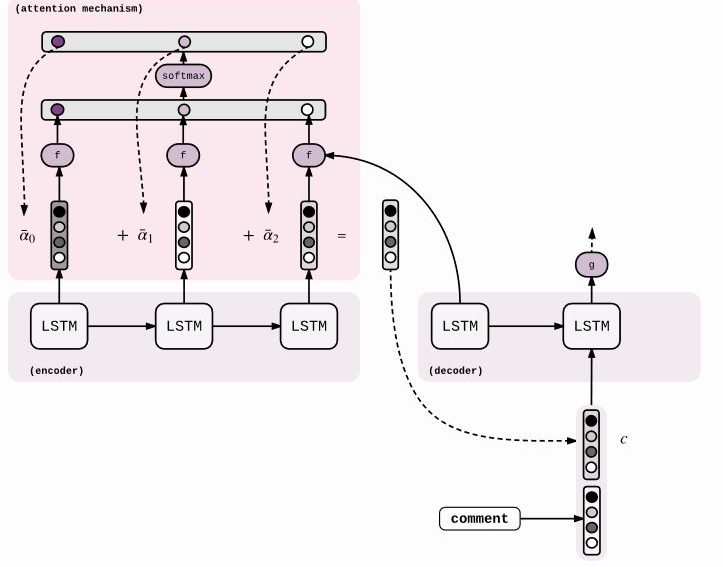
In diesem Modell wird neben dem Kontextvektor “Aufmerksamkeit” der im vorherigen Zeitschritt vorhergesagte Wert zum Eingang des LSTM-Netzwerks des Decoders addiert (in der Abbildung das Wort “comment”). Die Funktion f erzeugt die Aufmerksamkeitsgewichte.
LUONG ATTENTION
SOFT, GLOBALE, DOT GEWICHTETE ATTENTION
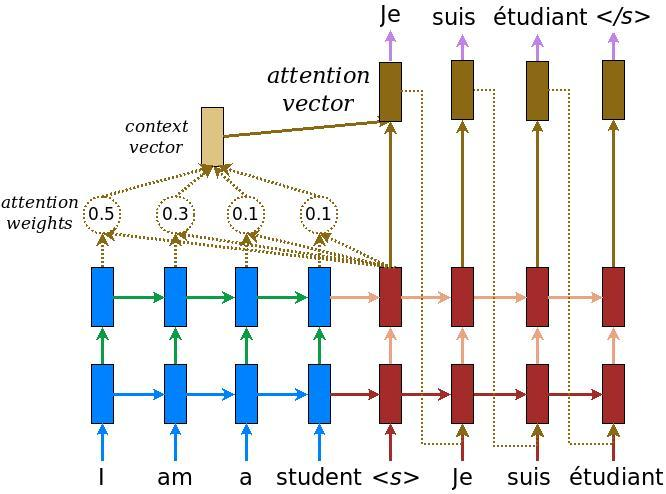
Die Ausgaben dieses Modells werden nicht vom üblichen LSTM-Decoder ausgegeben, sondern werden aus einem Attentionsvector unter Verwendung eines neuronalen FC-Netzwerks berechnet. Der Attention-Vektor ist die Verkettung des Attention-Kontextvektors und der Decoder-Ausgabe.
Um die für die Erzeugung des Aufmerksamkeitskontextvektors erforderliche Gewichtung zu erstellen, verwenden wir den aktuellen Status des Decoders (beachten Sie den Unterschied: Der vorherige Status wurde in den vorherigen Modellen verwendet) und alle Codierungen. Hier ist der LSTM-Eingang des Dekoders der vorherige Attentionsvektor und das vorhergesagte Wort. In diesem Modell beeinflusst der Attention-Mechanismus sowohl die Eingabe als auch die Ausgabe.
BAHDANAU ATTENTION
SOFT, GLOBALE, FC GEWICHTETE ATTENTION
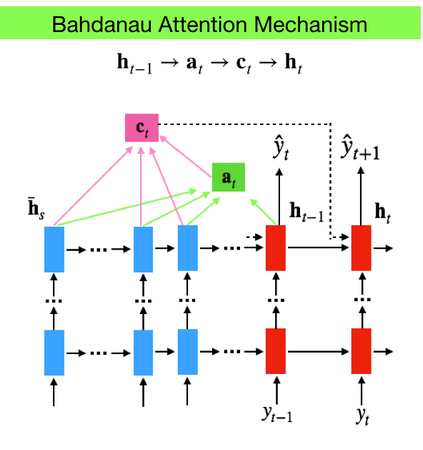
Das erste beliebte Modell. Der Kontextvektor wird von einem FC-Netzwerk unter Verwendung des Decoderstatus des vorherigen Zeitschritts und der Eingangskodierungen berechnet. Im Gegensatz zu den vereinfachten Attention-Mechanismen wird hier der Anfangsstatus des Attention-Kontextvektors bei jedem Zeitschritt mit dem vorherigen Decoder-Status verkettet und dann der LSTM-Decoder-Schicht hinzugefügt. Der Decoder erhält, ähnlich wie bei den Sprachmodellen, im vorherigen Zeitschritt eine eigene Ausgabeschätzung.
Wir sind sicher, dass es in Ihrem Unternehmen viele Aufgaben gibt, die mit AI automatisiert werden können: Wenn Sie die Vorteile der künstlichen Intelligenz genießen möchten, wenden Sie sich an unsere kostenlose Beratung bei einem unserer Ansprechpartner.

QUELLE(N):
[1] https://docs.microsoft.com/hu-hu/azure/machine-learning/desktop-workbench/scenario-tdsp-biomedical-recognition
[2] https://towardsdatascience.com/recurrent-neural-networks-and-lstm-4b601dd822a5
[3] https://www.semanticscholar.org/paper/Sequence-to-Sequence-Prediction-of-Vehicle-via-LSTM-Park-Kim/9bebd98cd01752df4aae7e4969063267ad542fc4
[4] Thang Luong et al. Effective approaches to attention-based neural machine translation. 2015
[5] Dzmitry Bahdanau et al. Neural Machine Translation by Jointly Learning to Align and Translate, 2014
[6] https://www.cnblogs.com/hezhiyao/p/8747019.html
[7] https://guillaumegenthial.github.io/sequence-to-sequence.html
[8] https://i.stack.imgur.com/I0Wyv.png
[9] http://cnyah.com/2017/08/01/attention-variants/