Es fährt die selbstfahrenden Autos, aber es ist in Schwierigkeiten, wenn es zählen muss. Weißt du, worüber ich rede? Die Antwort ist überraschend: das sind neuronale Netzwerke. Das neue Forschungspapier von DeepMind versucht dieses Problem zu lösen.
Ein neuronales Netzwerk kann mit den Trainingsbeispielen unglaublich komplexe Funktionen abbilden, es ist jedoch schwierig, dies zu verallgemeinern. Diese Tatsache war ein Albtraum für die Forscher. Denken Sie an folgende Situation: Wenn Sie sich auf eine Mathematikprüfung vorbereiten. Sie haben zwei Möglichkeiten: Sie lernen die gelösten Übungen aus der Klasse und hoffen, dass der Lehrer faul ist und keine neuen Übungen erfindet. ODER Sie verstehen die Logik hinter den Übungen. Die beiden Methoden unterscheiden sich nicht, bis die Beispiele dieselben sind, wie sie in der Klasse gelöst wurden. Aber was passiert, wenn es nicht stimmt?
Die neuronalen Netzwerke können nicht gut verallgemeinern, also lernen sie wie der erste Schüler des Gedankenexperiments. Wir können dieses Verhalten leicht beobachten, indem wir einfach einem neuronalen Netzwerk beibringen, eine einfache y = x-Funktion zu erstellen. Zuerst müssen Sie die Trainingsbeispiele erstellen, also:
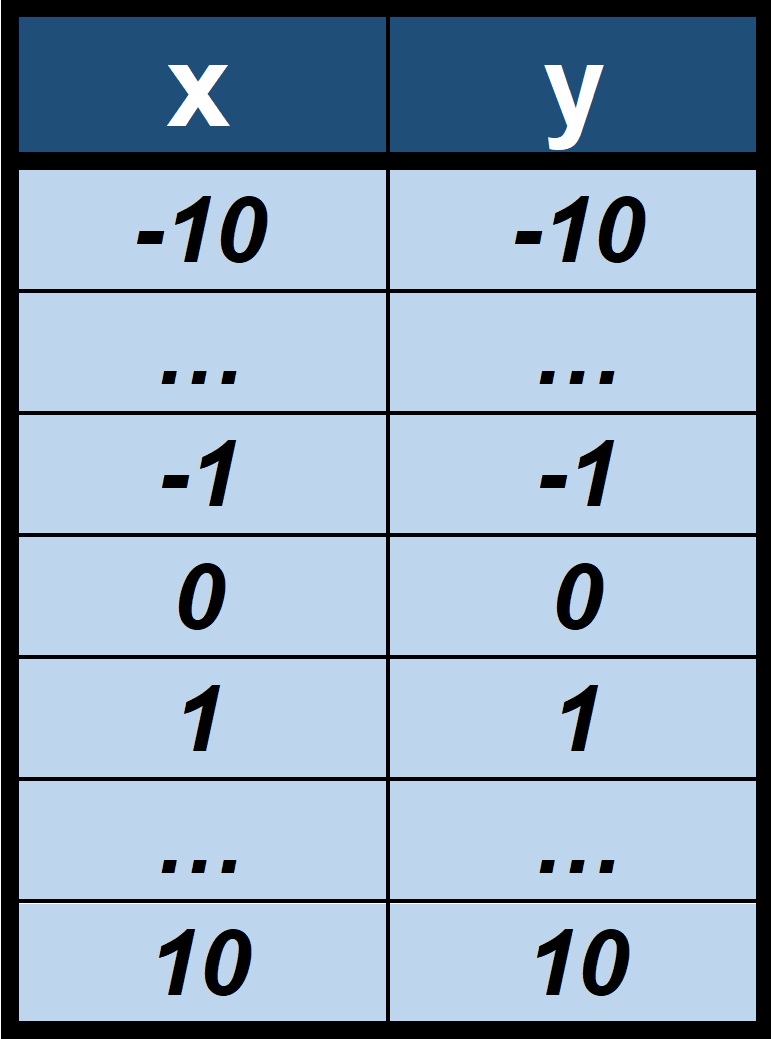 Im Trainingsbereich kann der NN diese Gleichung perfekt lösen, aber außerhalb dieses Bereichs schlägt er fehl. Die Frage ist, warum?
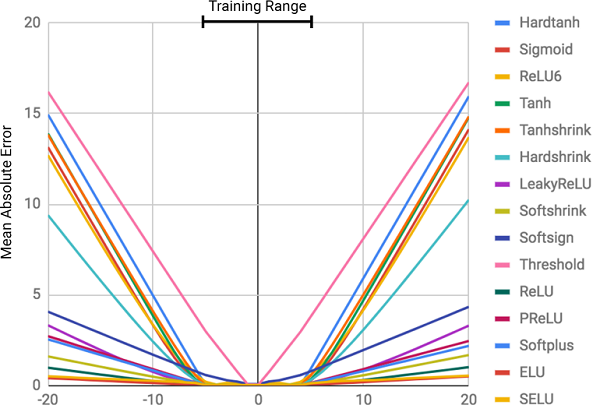
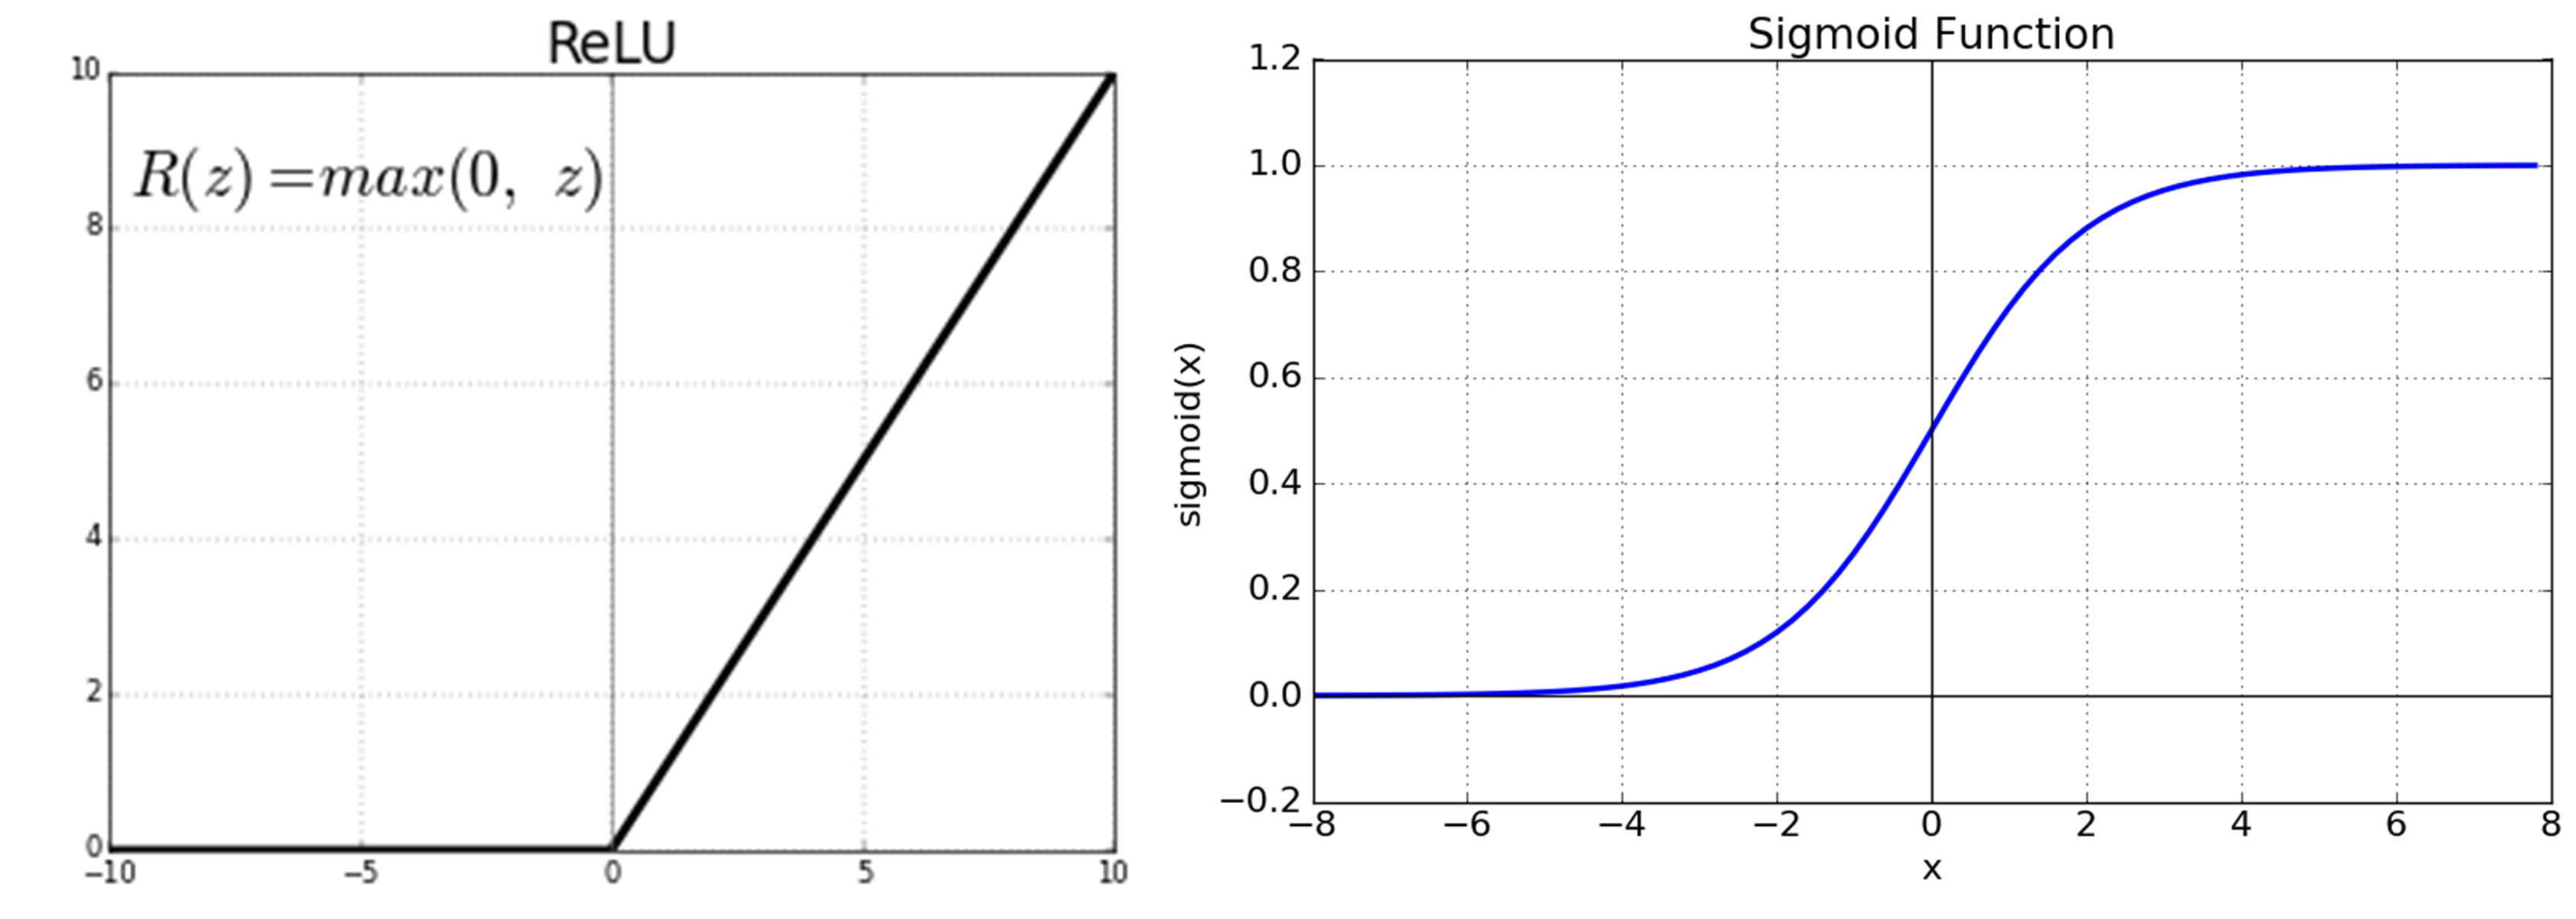
Die Antwort lautet: wegen der nichtlinearen Aktivierungen. Ohne sie können wir komplexe Funktionen nicht zwischen Eingabe und Ausgabe abbilden, sondern beschränken uns auf numerische Berechnungen. Je unlinearer die Aktivierung ist, desto größer ist der Extrapolationsfehler. Zum Beispiel kann eine RELU-Aktivierung mit einem kleinen Fehler extrapolieren, eine Sigmoid-Aktivierung kann dies nur mit sehr großem Fehler tun.
Dieses Kardinalproblem wird durch die Veröffentlichung von DeepMind in den folgenden Tagen gelöst: Neuronale Arithmetik-Logikeinheiten.
NAC
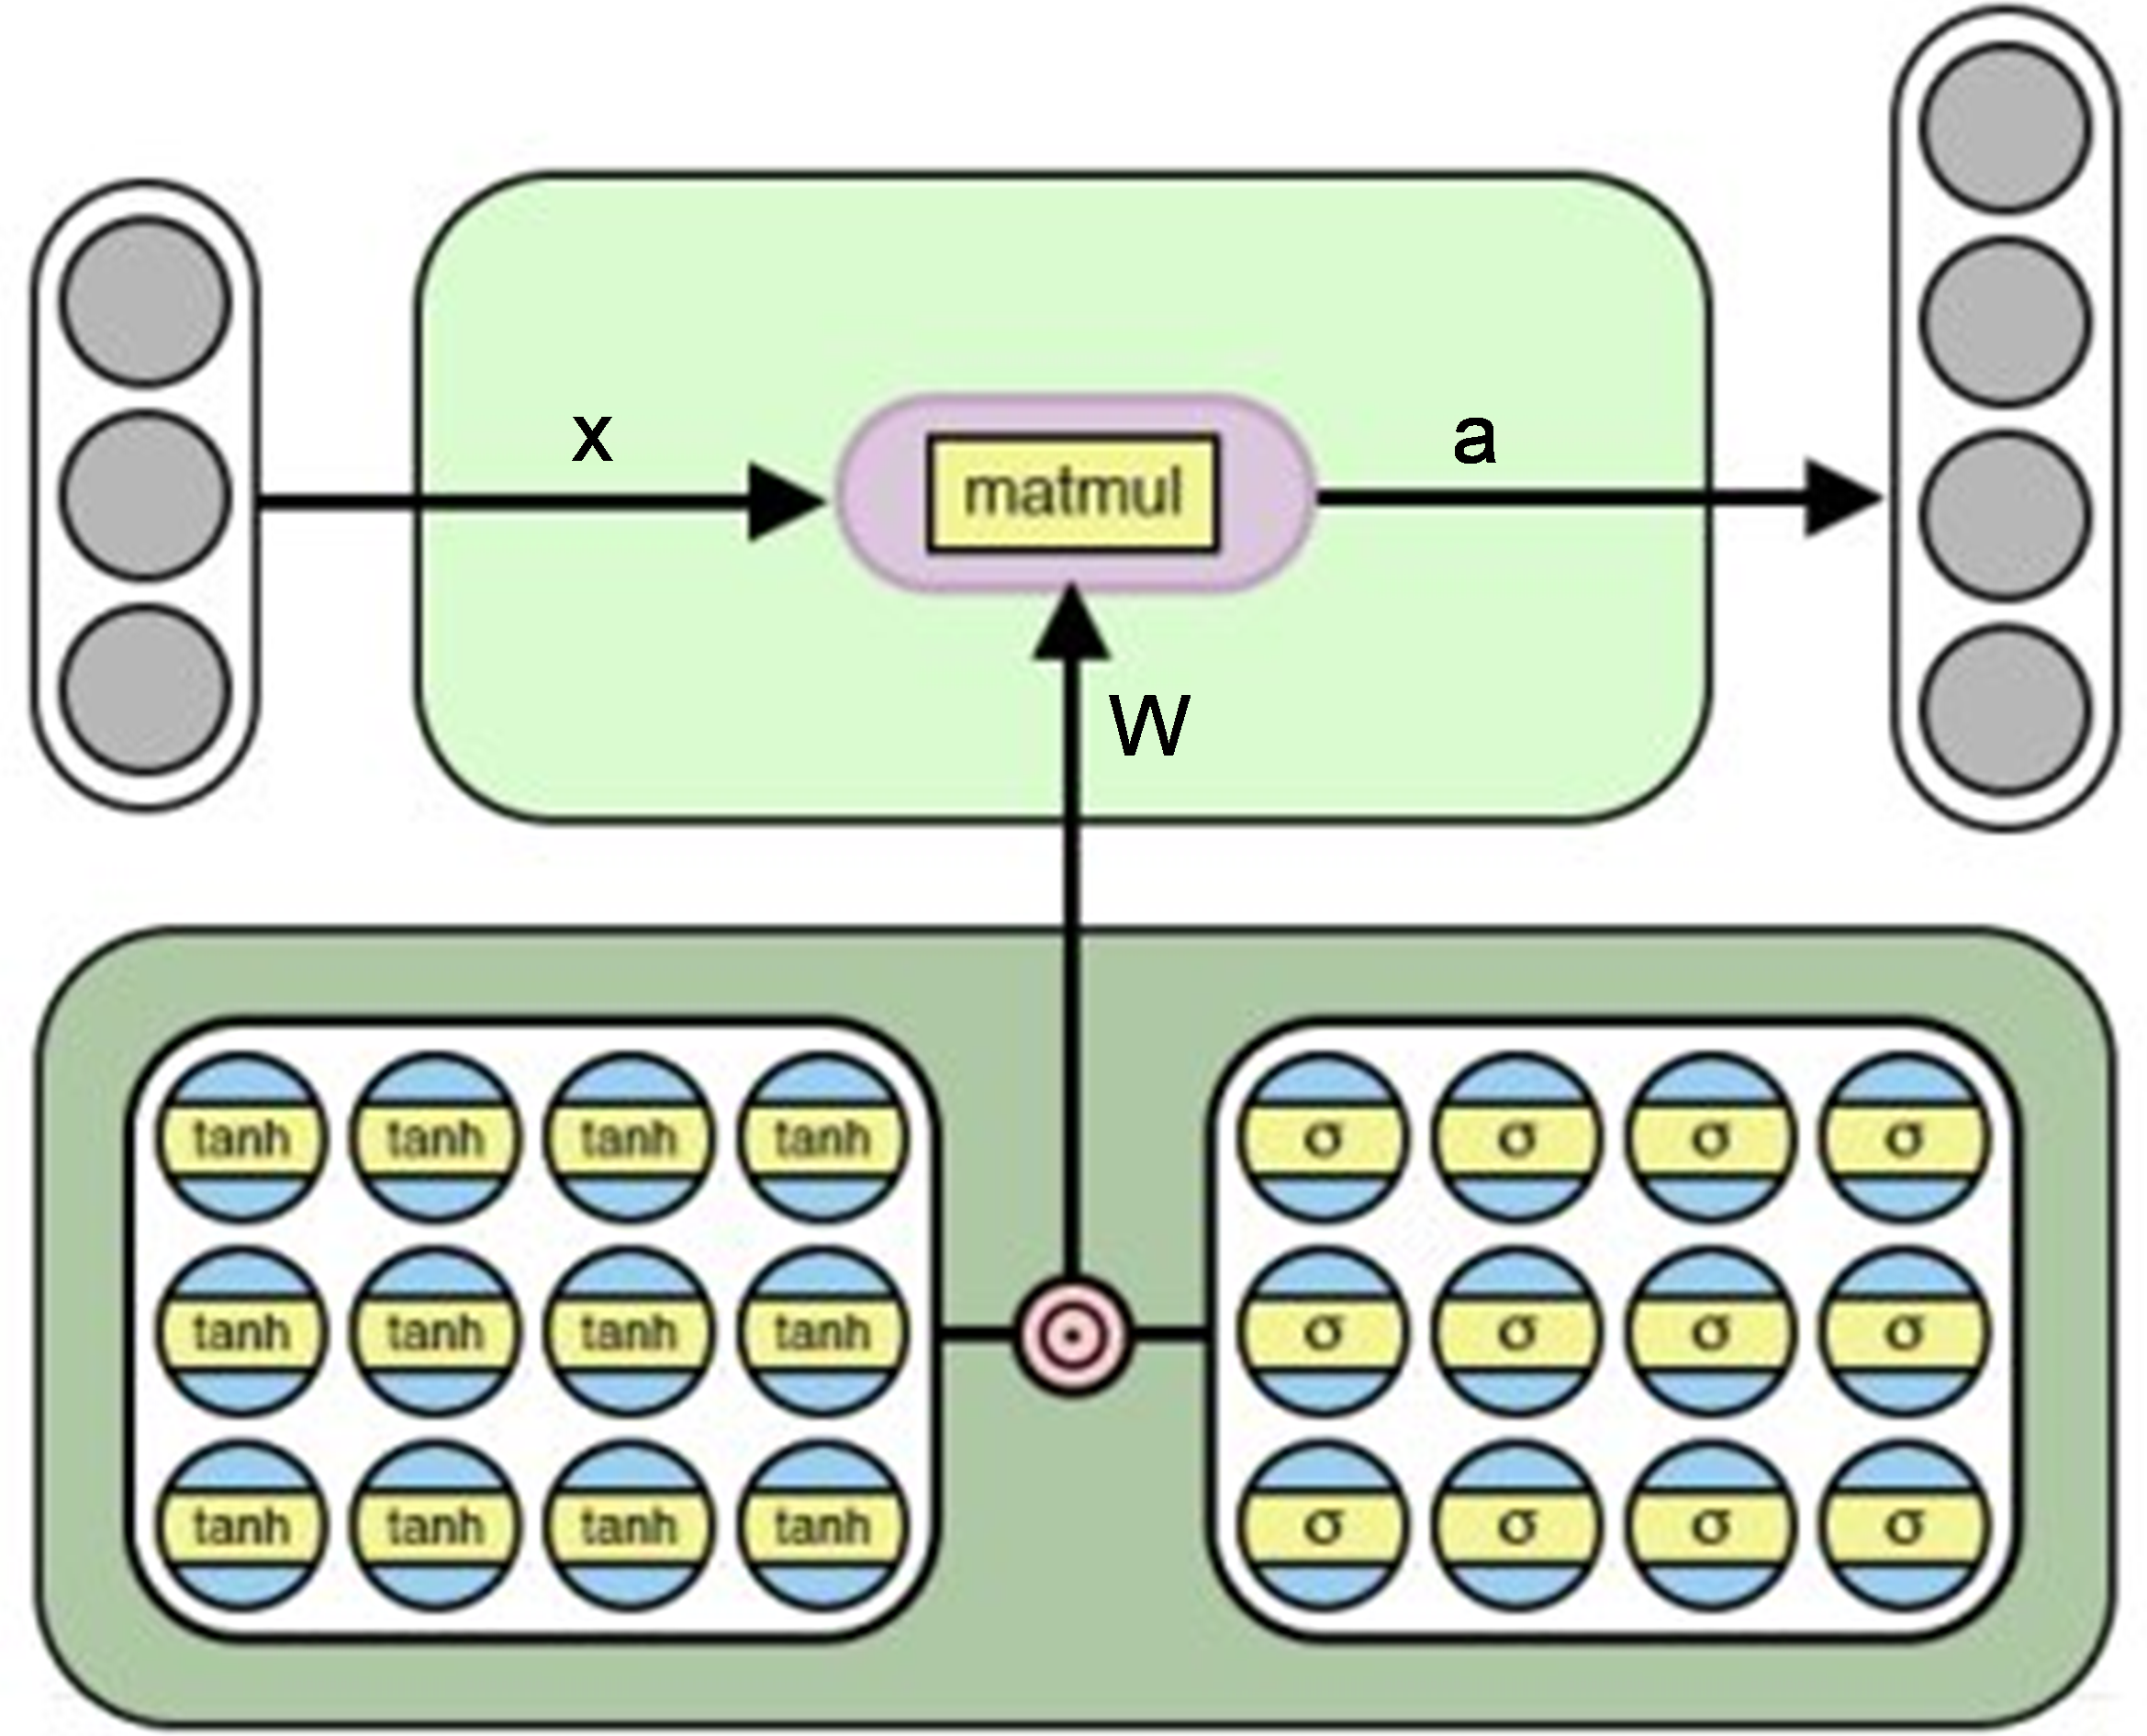
Die Schlüsselidee ist das NAC-Modul. Seine Funktion zum Addieren und Subtrahieren zwischen den Eingangsdaten (Linearkombination) ohne Skalierung. Dies wird mit einer W-Matrix erreicht, deren Gewichtung nur -1, 0, 1 betragen kann. Nach dieser Multiplikation werden keine Aktivierungen vorgenommen. Dies kann zu beliebigen Zeiten ohne Vorurteile erfolgen. Dadurch kann das Netzwerk außerhalb des Trainingsbereichs extrapolieren.

Die Gewichtungsmatrix kann durch Zuweisen dieser drei diskreten Werte erstellt werden, ist jedoch nicht unterscheidbar. Aus diesem Grund verwenden wir die Gleichung auf der rechten Seite. Es garantiert, dass die Gewichte nahe an dieser Zahl liegen, mit einem kleinen Fehler. Weitere Einfachheit ist, dass W ^ und M ^ mit den herkömmlichen Verfahren initialisiert und optimiert werden können.
Die Notwendigkeit besteht auch für die komplexen numerischen Funktionen, zum Beispiel Multiplikation und Division. Was können wir tun? Im Logbereich können die Addition und die Subtraktion als Multiplikation und Division behandelt werden. Wir haben alle diese Protokolleigenschaften bekannt. Wenn wir die W-Matrix, die im vorherigen Abschnitt erstellt wurde, beibehalten und auf die Protokolle der Eingaben anwenden, erhalten Sie mit der Anwendung der Exponentialfunktion das erwartete Ergebnis.
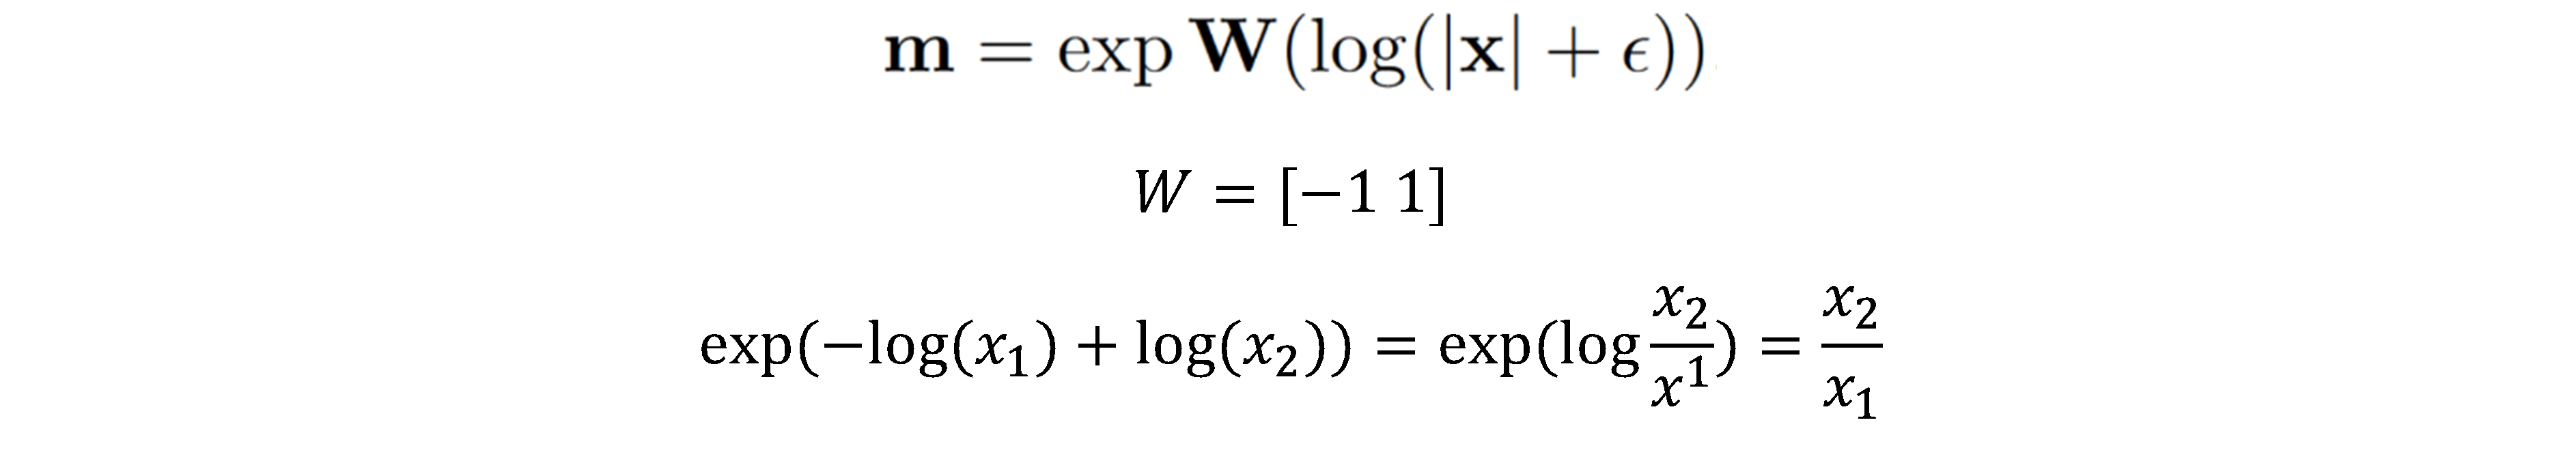
Es gibt ein Epsilon, um die numerischen Probleme mit log (0) zu beseitigen.
NALU
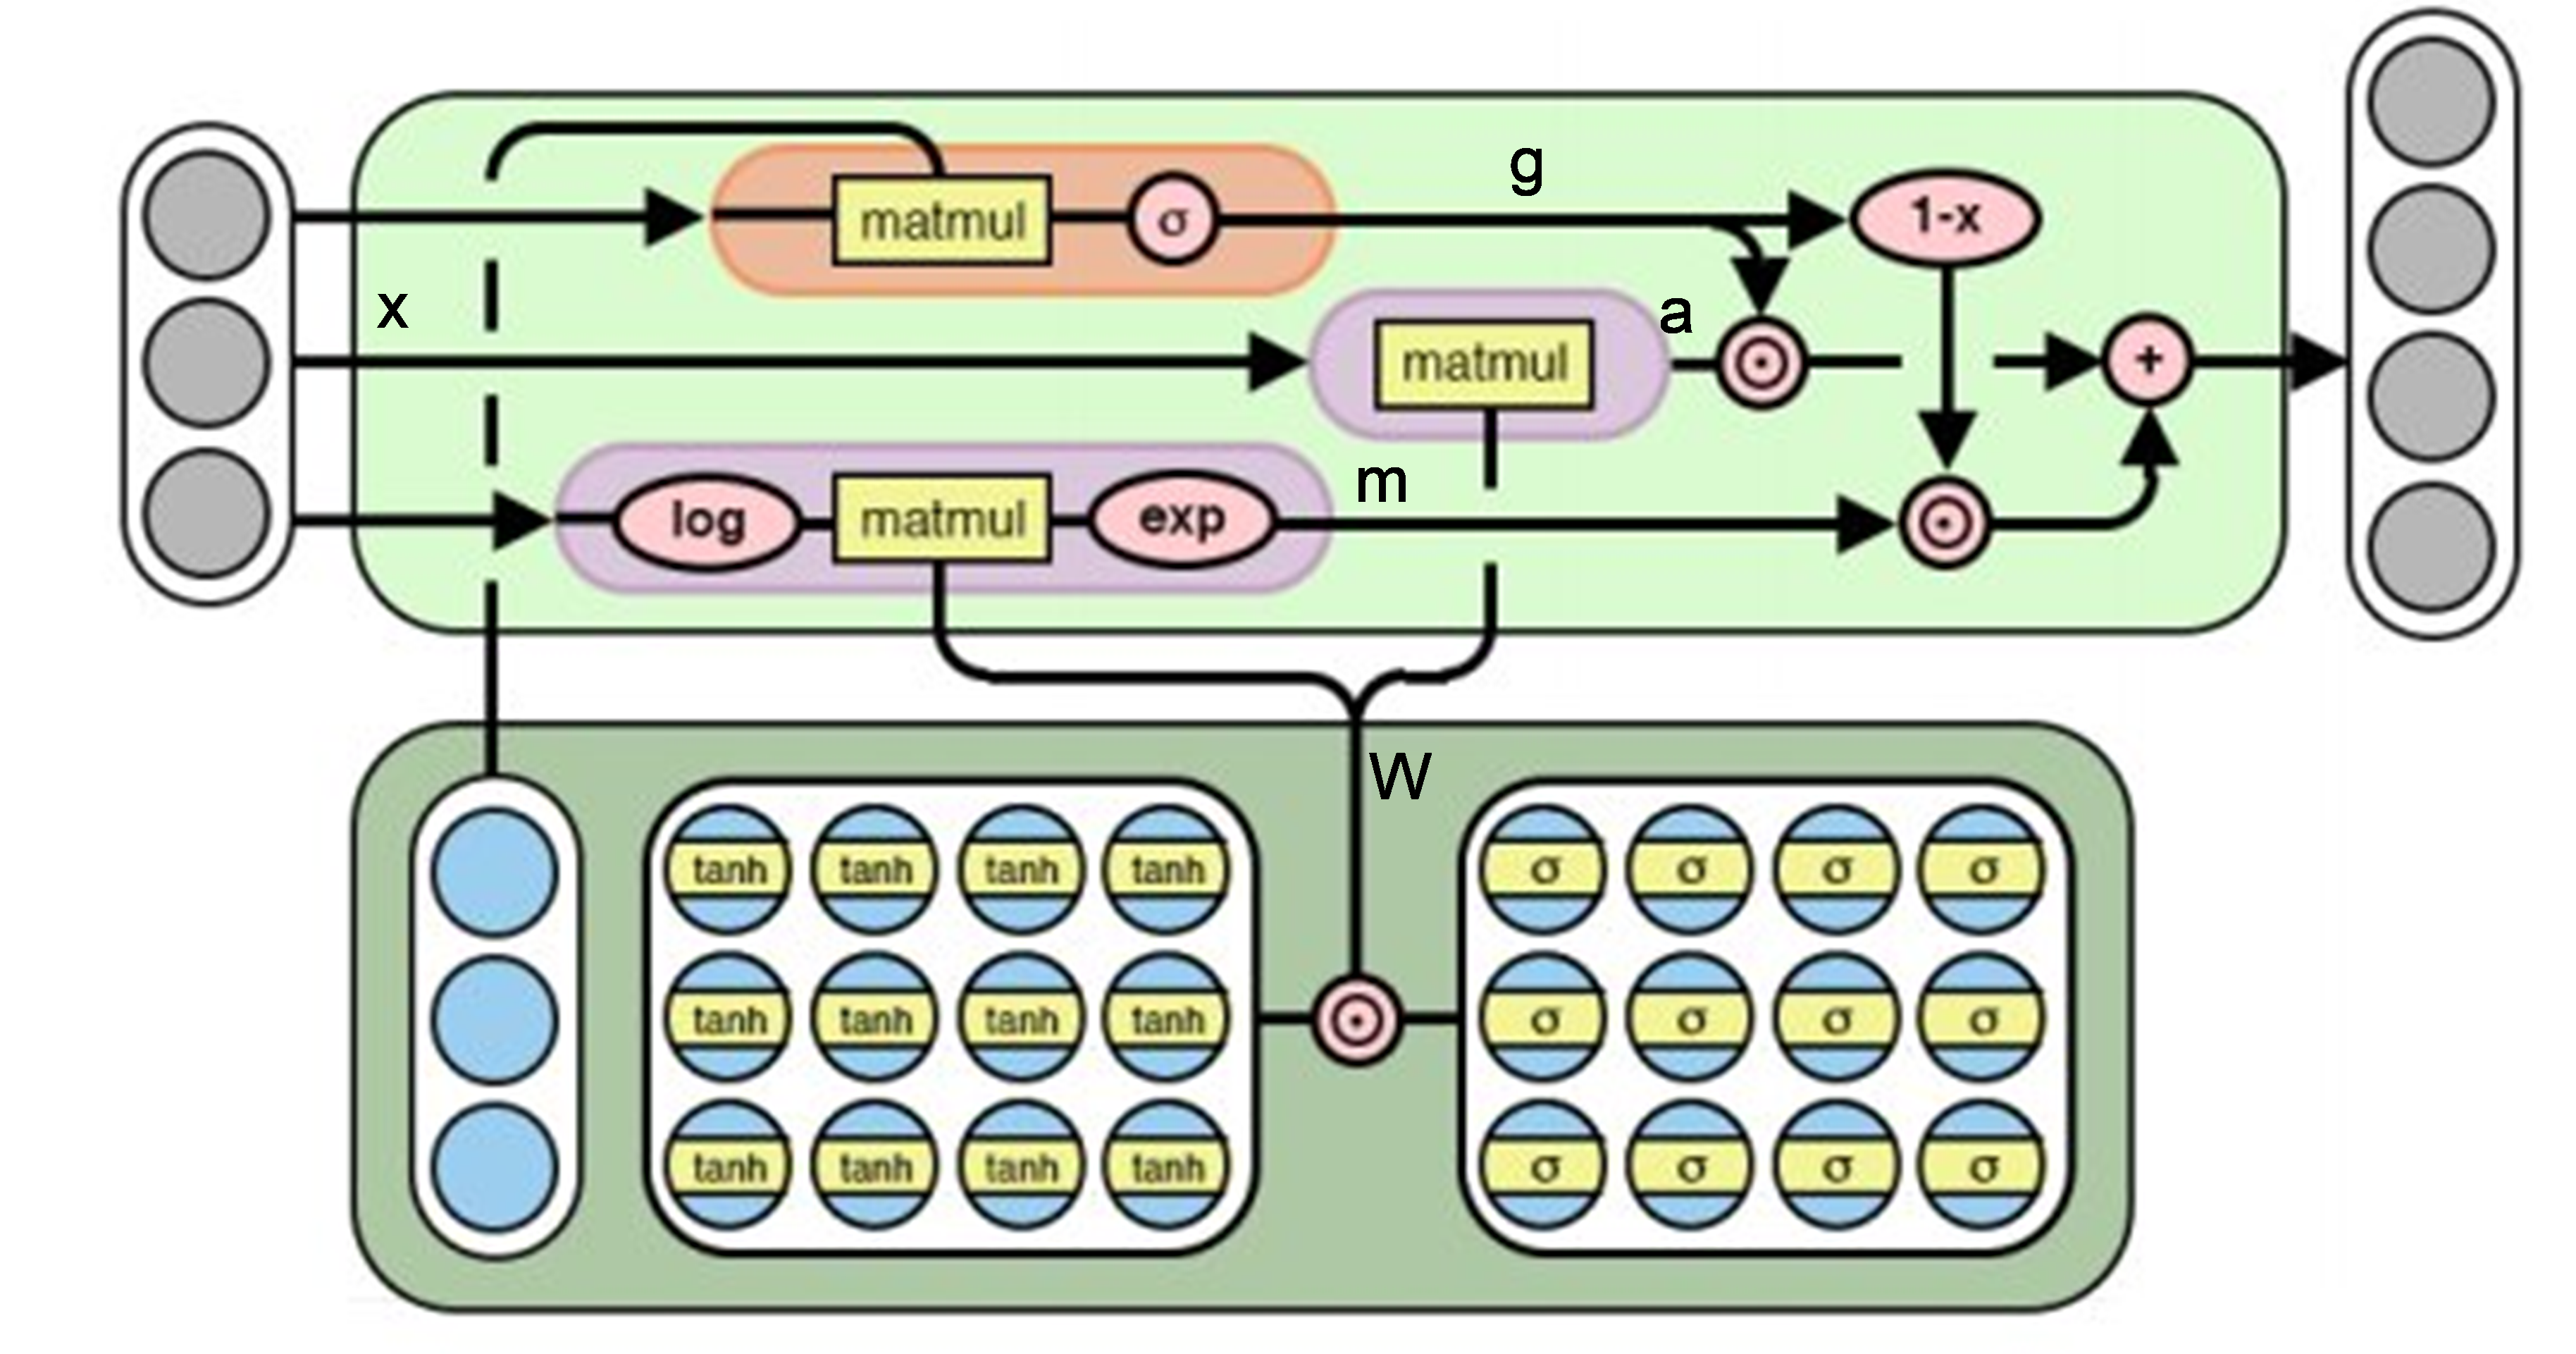
Wir haben jetzt zwei NAC-Module (in der Abbildung violett), die Grundbaustein unserer NALU sind und als grundlegende numerische Funktionen dienen. Diese beiden NAC mit einem Sigmoid-Gate (orange in der Abbildung) bilden die NALU-Architektur. Mit dem Sigmoid-Gate kann das Modell bestimmen, welche grundlegende Funktion für die hohe Genauigkeit benötigt wird. Diese NALU-Architektur kann die Grundfunktionen perfekt simulieren und kann somit auch außerhalb des Trainingsbereichs generalisiert werden. Das NALU-Modul kann problemlos mit anderen Netzwerken (RNN, CNN, FC) verbunden werden.
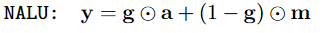
In der Arbeit testen die Forscher dieses Modul an verschiedenen Aufgaben und erreichten bei vielen Problemen Stand der Technik. Zum Beispiel: Die Übung besteht darin, die verschiedenen MNIST-Zeichen zu zählen oder zusammenzufassen. Die Netzwerke wurden an 10 langen Eingabedaten trainiert, die Abbildung zeigt das Ergebnis:
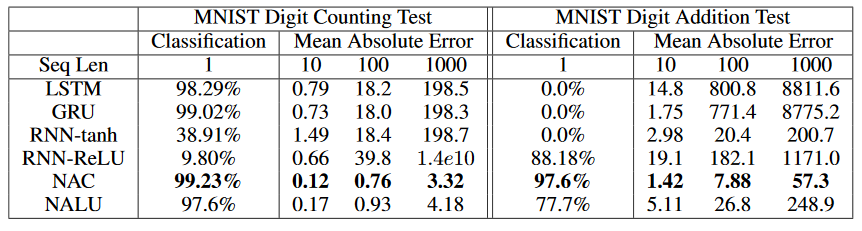
Die Ergebnisse zeigen, dass das Modell innerhalb und außerhalb des Trainingsbereichs um Größenordnungen bessere Ergebnisse erzielt als die bekannten und verwendeten Modelle. Diese neue Architektur wurde an einer anderen Aufgabe getestet, wie der Umwandlung der geschriebenen Zahlen in Ziffern und der Lösung numerischer Probleme von RL-Agenten
Natürlich kann es nicht für jedes Problem gut passen, aber es zeigt eine neue Modellstrategie, mit der numerische Funktionen zu einer vorhandenen Architektur hinzugefügt werden können.
Wir sind sicher, dass es in Ihrem Unternehmen viele Aufgaben gibt, die mit AI automatisiert werden können: Wenn Sie die Vorteile der künstlichen Intelligenz genießen möchten, wenden Sie sich an unsere kostenlose Beratung bei einem unserer Ansprechpartner.

REFERENZE:
[1] Neural Arithmetic Logic Units. arXiv: 1808.00508v1 [cs.NE]. arxiv.org/abs/1807.09882
[2] https://mlnotebook.github.io/post/transfer-functions/
[3] https://medium.com/@kanchansarkar/relu-not-a-differentiable-function-why-used-in-gradient-based-optimization-7fef3a4cecec


